2026 年漫畫翻譯哪個 AI 模型最好:6 個模型 46 頁實測
2026 年翻譯漫畫最好的 AI 模型是哪個:我們把同樣的 46 頁漫畫交給 6 個模型,從 GPT-6 到 Gemini 和 Claude Opus,數出每個模型翻錯了幾句。
Serifu · · 閱讀時間 7 分鐘
在我們 2026 年 10 月的測試裡,翻譯漫畫最好的 AI 模型是 gemini-3.8-flash 和 claude-opus-5-5:46 頁下來,兩個都沒有明顯的錯誤。 gpt-6-sol 有 1 處,gpt-6-luna 有 3 處,claude-sonnet-5-5 有 5 處,claude-haiku-5-5 有 9 處。模型比較大,翻譯不一定比較好:一個輕量模型贏過了一個中型模型。
我們做的是漫畫翻譯器 Serifu,2026 年 10 月 10 日做了這次測試。測試沒有任何人贊助。
| 模型 | 46 頁裡明顯的錯誤 | 每頁花的時間(秒) | Serifu 裡有沒有 |
|---|---|---|---|
| gemini-3.8-flash | 0 | 約 15 | 有 |
| claude-opus-5-5 | 0 | 10 到 20,有時超過一分鐘 | 有 |
| gpt-6-sol | 1 | 約 7 | 沒有 |
| gpt-6-luna | 3 | 約 8 | 有,預設模型 |
| claude-sonnet-5-5 | 5 | 約 7 | 沒有 |
| claude-haiku-5-5 | 9 | 約 6 | 沒有 |
測試是怎麼做的
- 頁面: 46 頁,278 句:佐藤秀峰《ブラックジャックによろしく》第 1 卷的 35 頁(日文,開放自由二次利用),이호윤 的韓國條漫《동백꽃》的 9 頁(CC BY),還有 2 頁繁體中文的漫畫。全部翻譯成英文。
- 分兩輪: 第一輪是 25 頁一般的頁面。第二輪是 21 頁特地挑出來的、翻譯時容易出錯的頁面,而且在任何模型執行之前,就先寫下了正確的譯文必須做到什麼。
- 每個模型做的事都一樣: 每個模型拿到的都是各句的文字、這一頁的圖、前面兩頁,以及同一份要求:譯得像正式出版的英文版那樣。每個模型只跑一次,結果一字不改,思考都設在低或關閉。
- 什麼算錯: 意思錯了,人或性別錯了,人名或術語被改壞了,或者有詞沒翻譯。語氣平淡一點或活潑一點不算錯。
46 頁只跑一次,能看到的是我們遇到的這些錯誤,不是錯誤率。下面每張圖,都是頁面上的那一部分,旁邊是每個模型寫的譯文,一字不差。
頁面上的人是誰
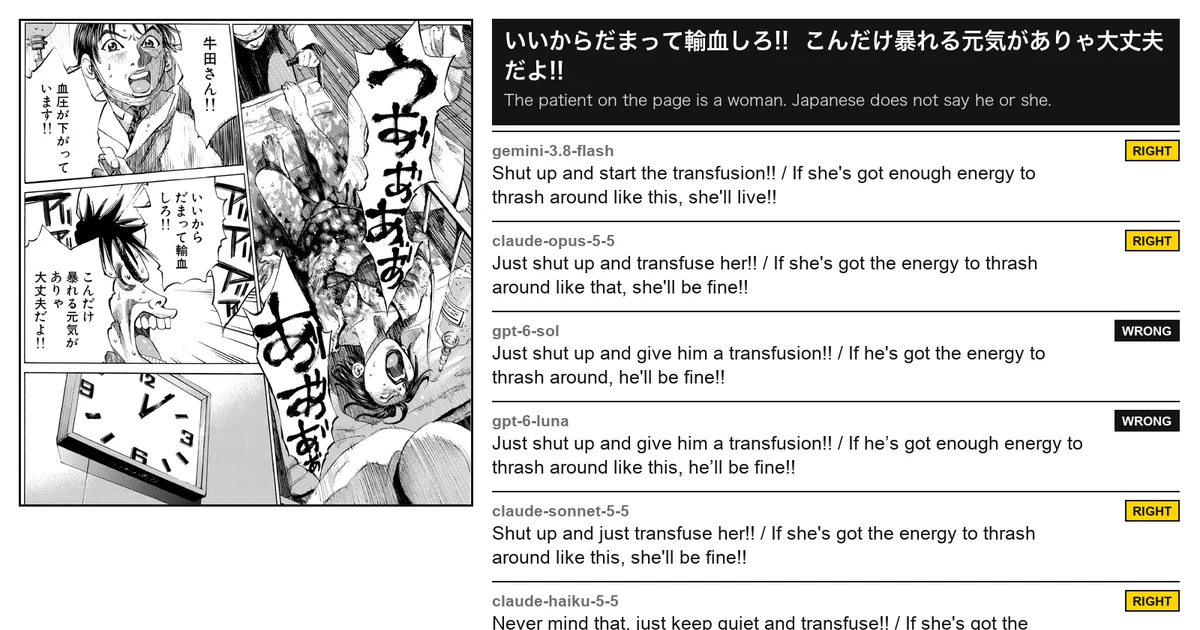
日文常常省略「他」和「她」。這一頁的病人是女性,只有畫面看得出來。兩個 GPT-6 模型都寫成了「him」(他);另外 4 個是從畫面上讀出來的。
一句話,兩個對話框
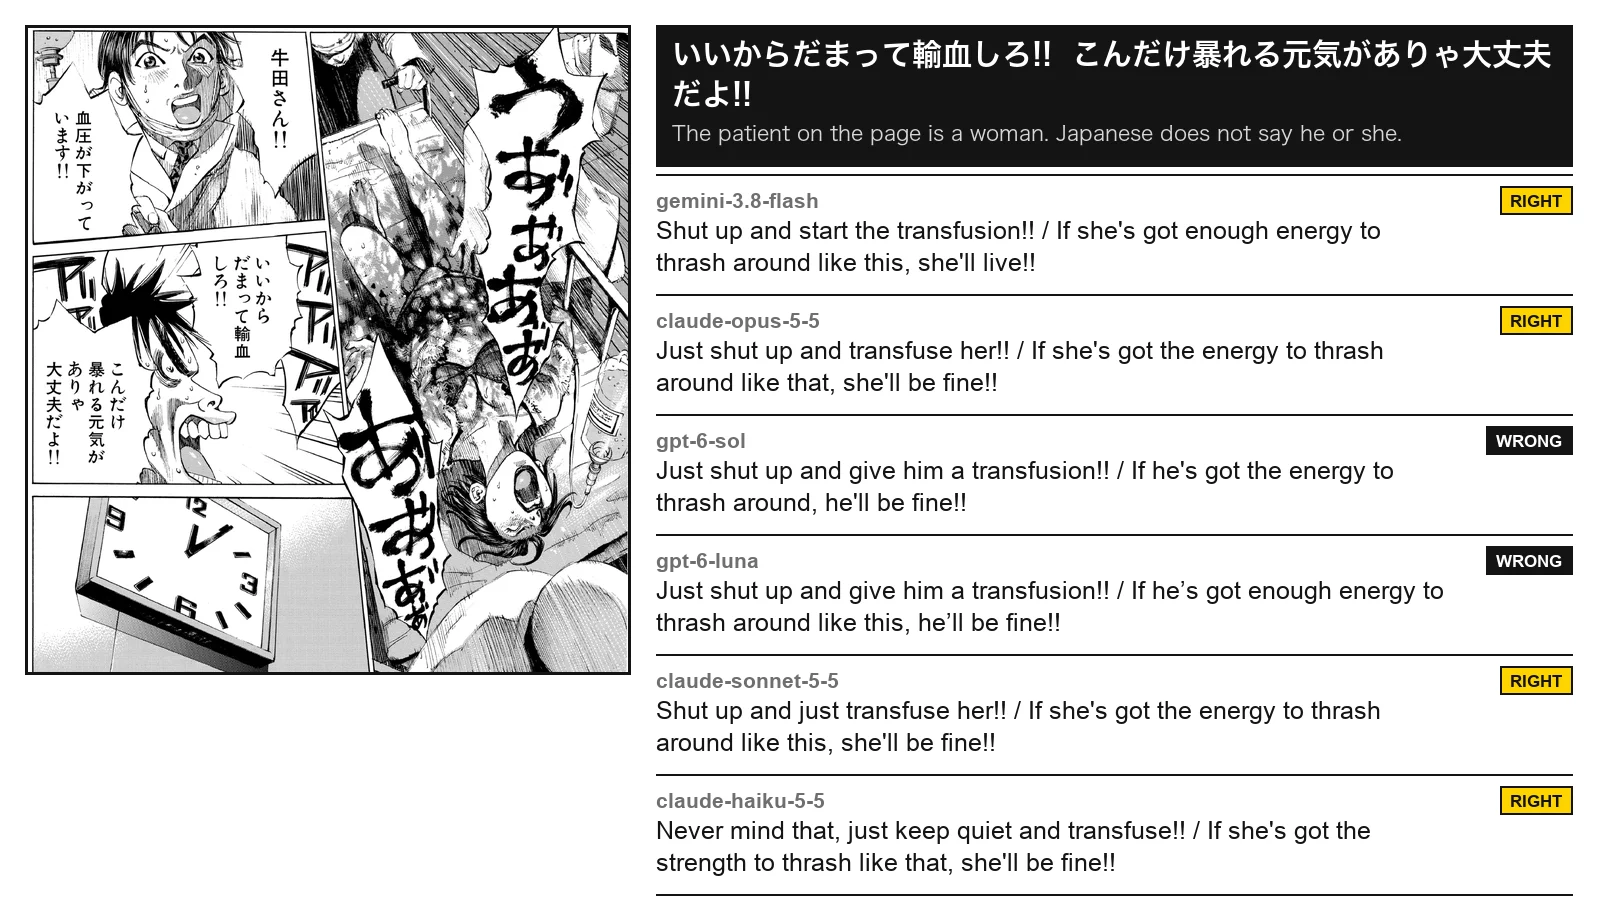
漫畫會把一句話拆進幾個對話框,每個對話框裡要放它自己的那一半。gpt-6-luna 在兩個對話框裡都寫了整句。
必須前後一致的名稱
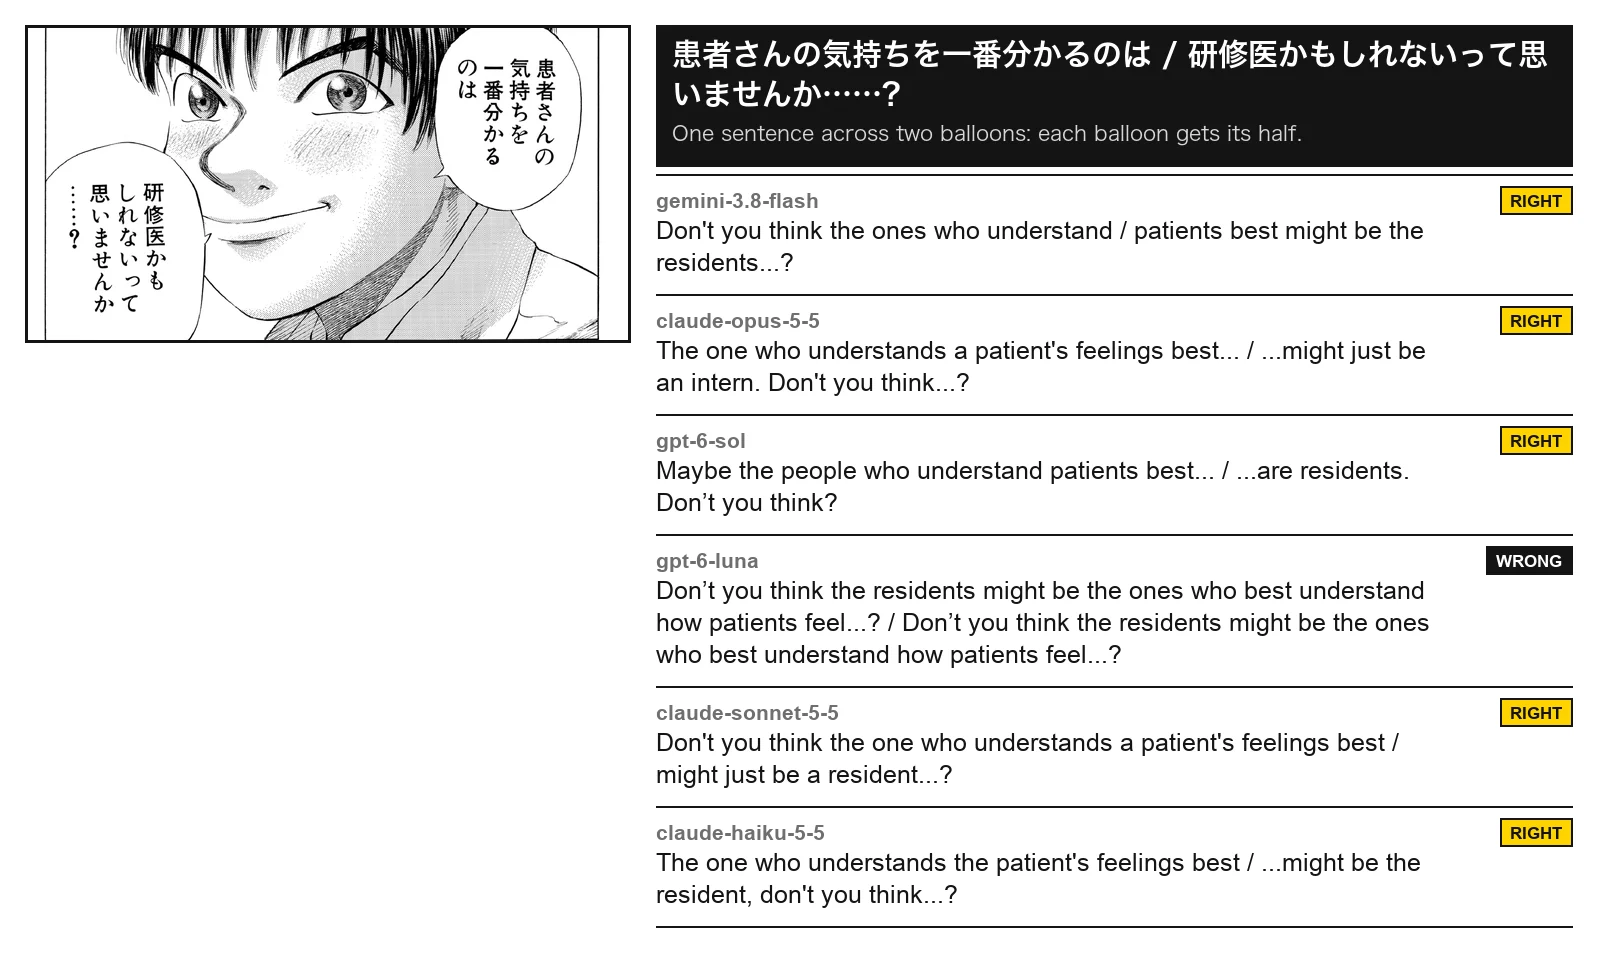
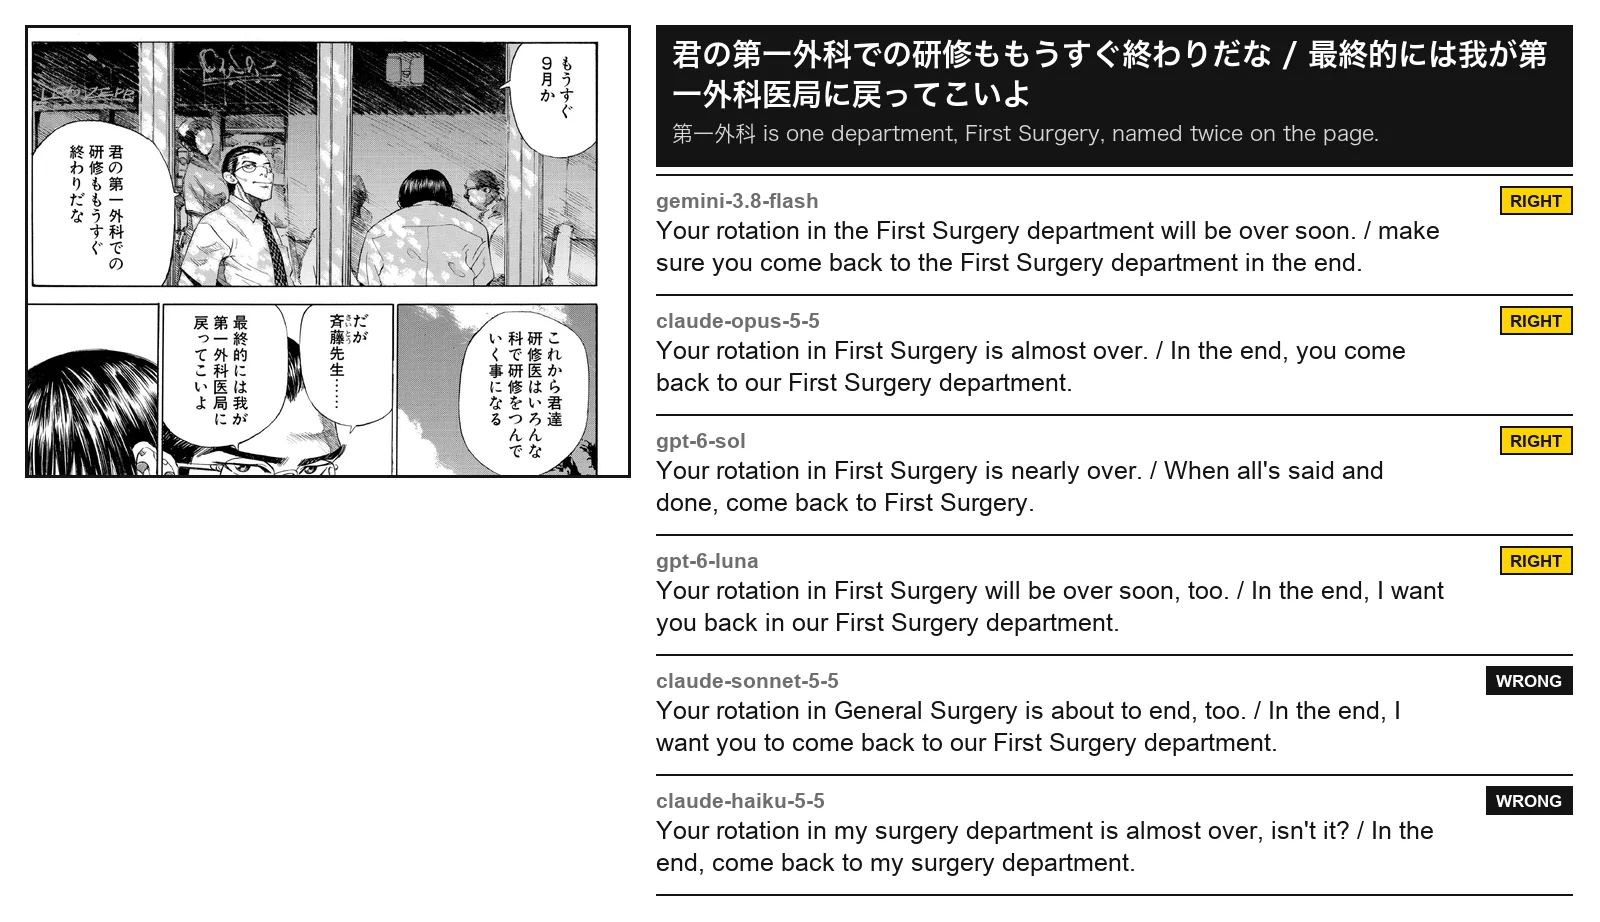
第一外科這個科別,在同一頁上出現了兩次。claude-sonnet-5-5 第一次寫成「General Surgery」(一般外科),第二次寫成「First Surgery」(第一外科);claude-haiku-5-5 兩次都漏了「First」。
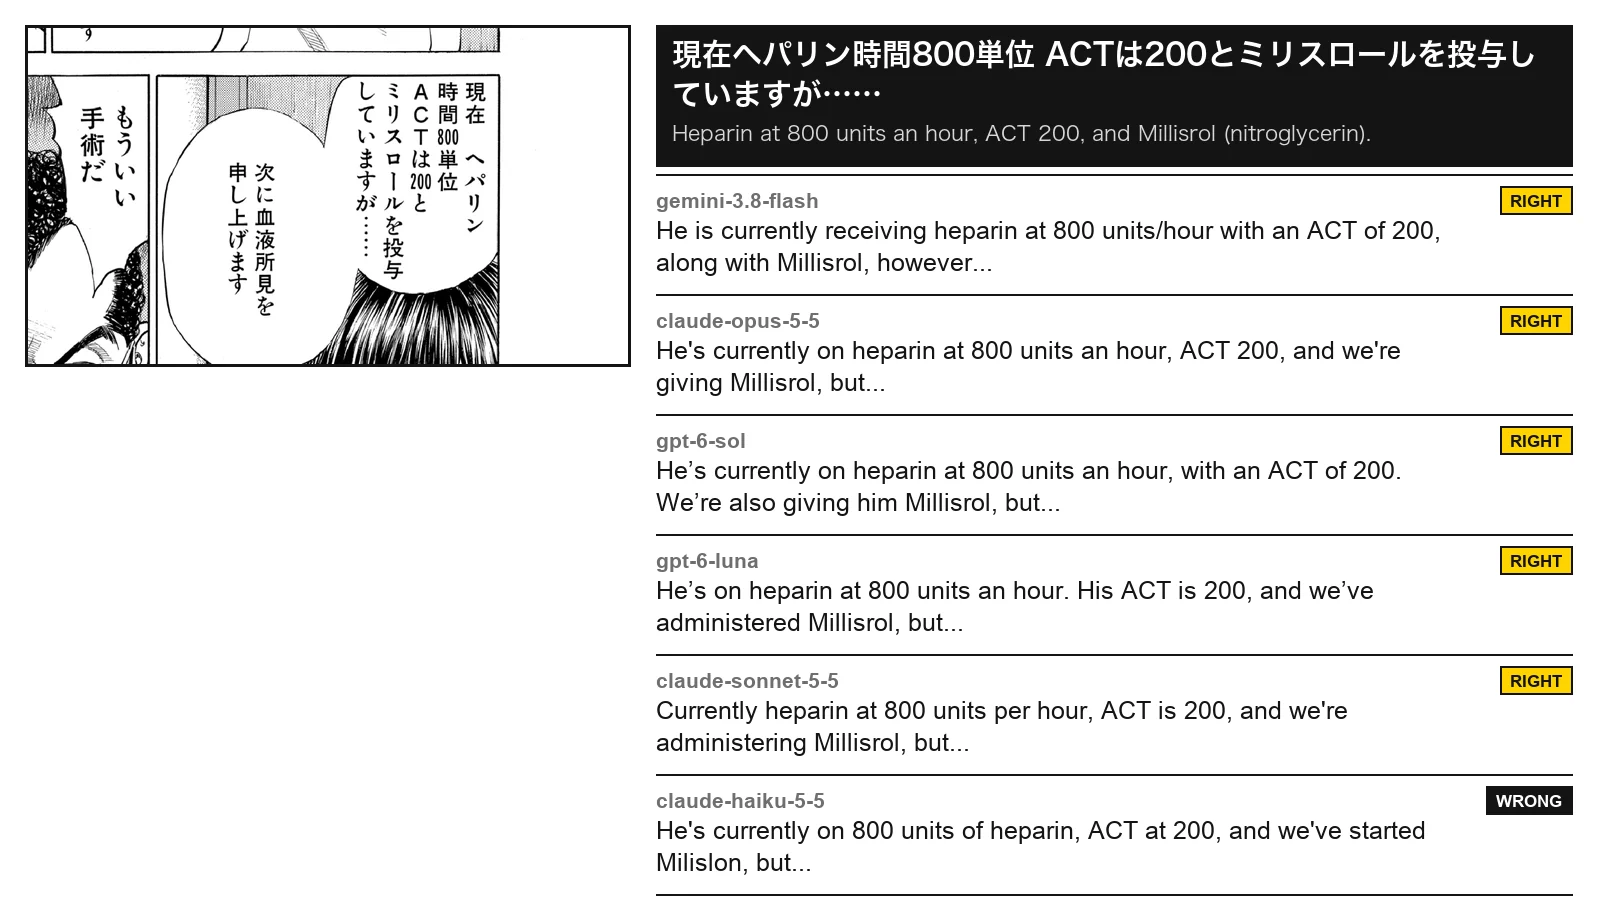
劑量和藥名
一名住院醫師報告:肝素每小時 800 單位,還用了一種叫 Millisrol 的藥。claude-haiku-5-5 漏了「an hour」(每小時),還把藥名拼成了「Milislon」。其他 5 個都對。
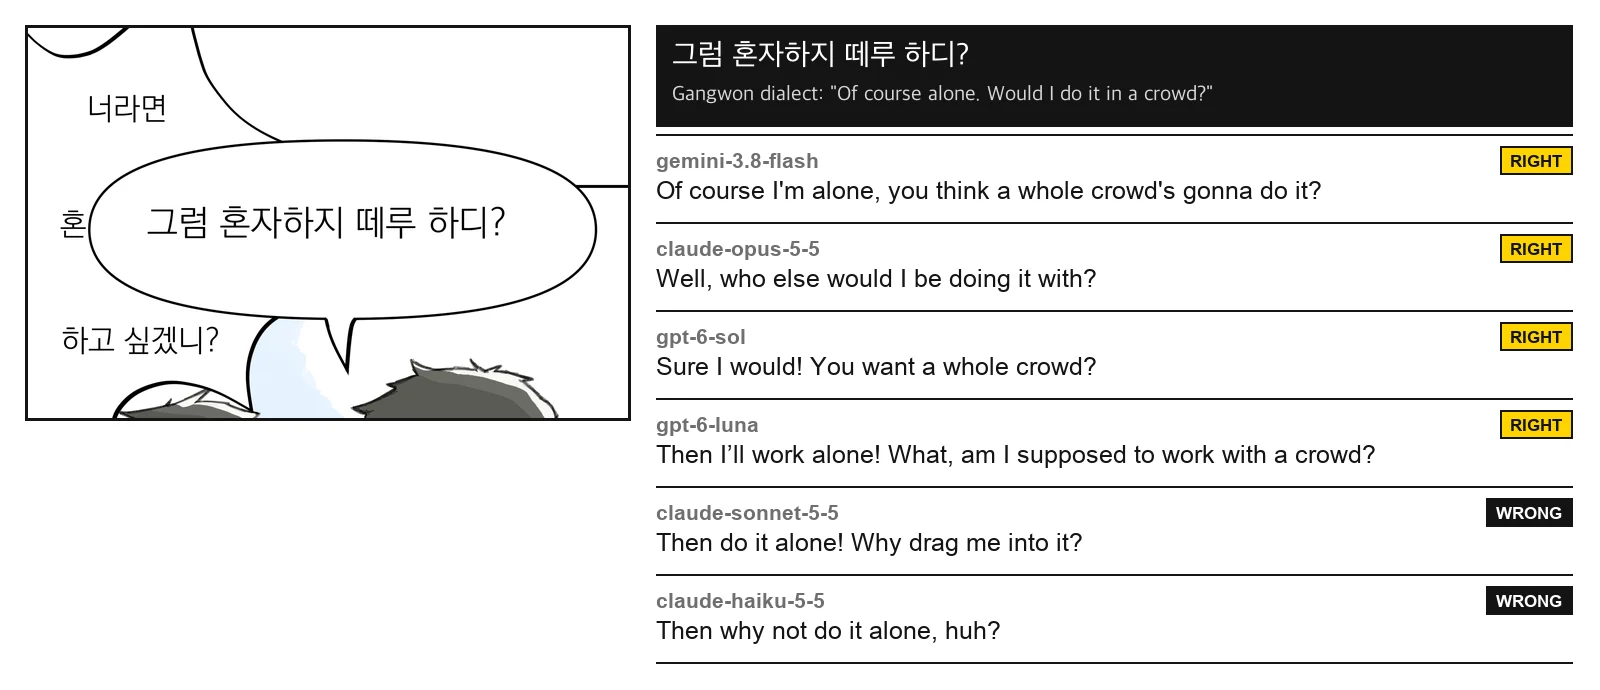
方言
那部韓國條漫的故事發生在山村,人物說的是江原道方言。有人問「你一個人做事嗎?」,少年頂了回去:當然一個人,難道還一大群人一起做?兩個 Claude 模型把這句頂嘴的話譯反了。
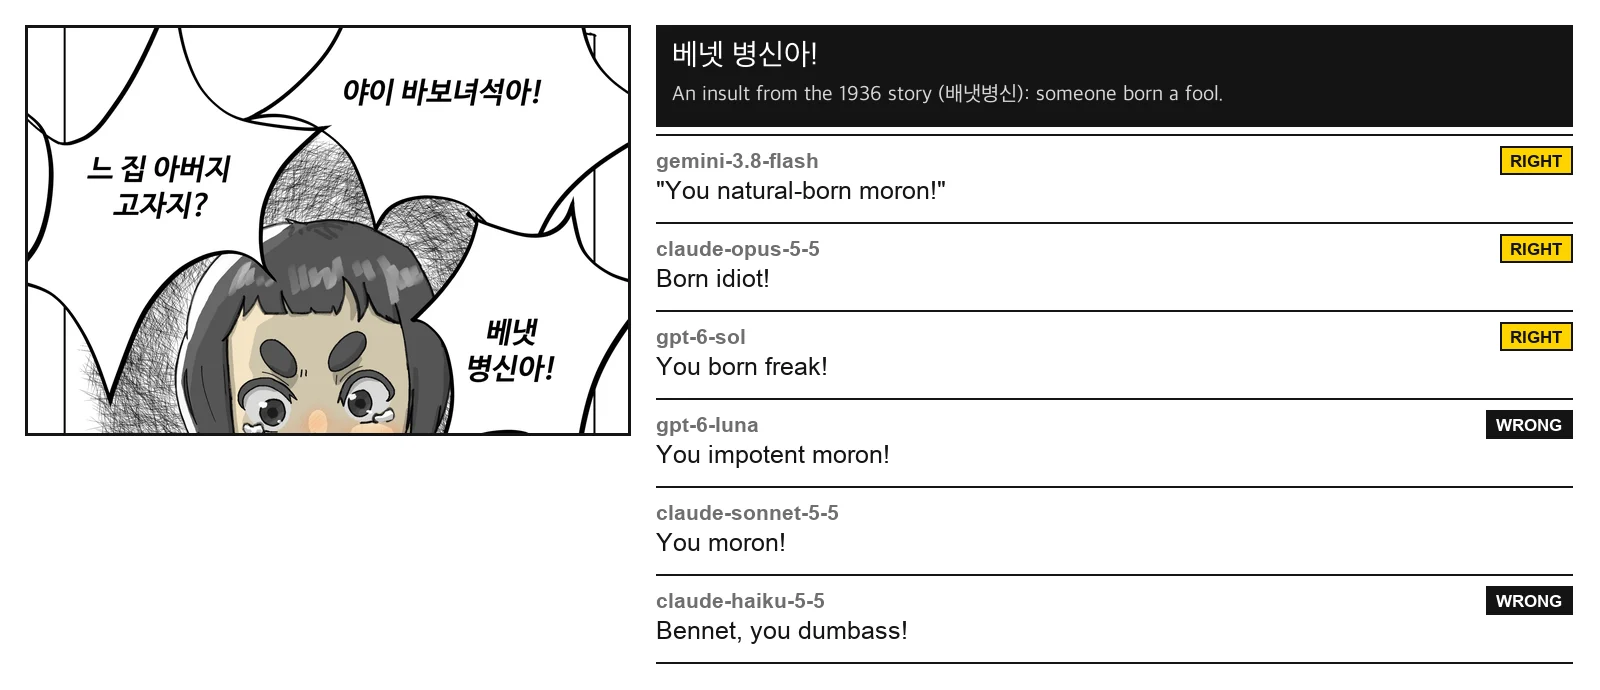
同一個故事裡還有一句老派的罵人話,罵人生下來就是傻子。claude-haiku-5-5 把它當成了人名「Bennet」;gpt-6-luna 寫成了「impotent」(性無能)。沒有模型拒絕翻譯這一句。
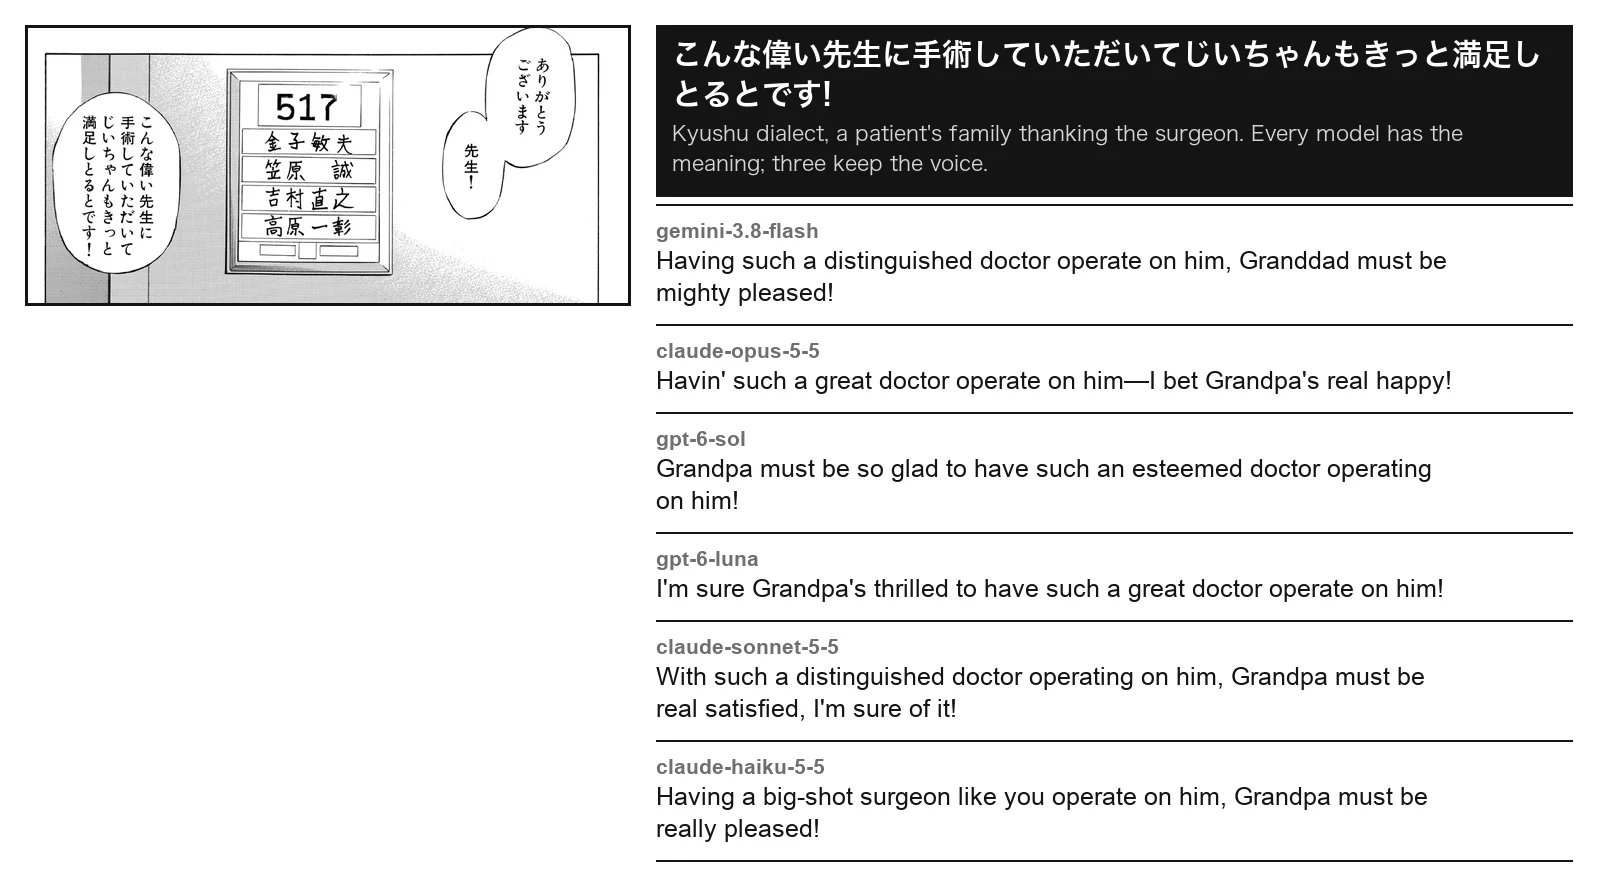
日文那邊,一家從九州來的人用家鄉的方言向外科醫師道謝。6 個模型意思都對。其中 3 個在英文裡還保留了鄉下人說話的口氣:claude-opus-5-5、gemini-3.8-flash 和 claude-sonnet-5-5。
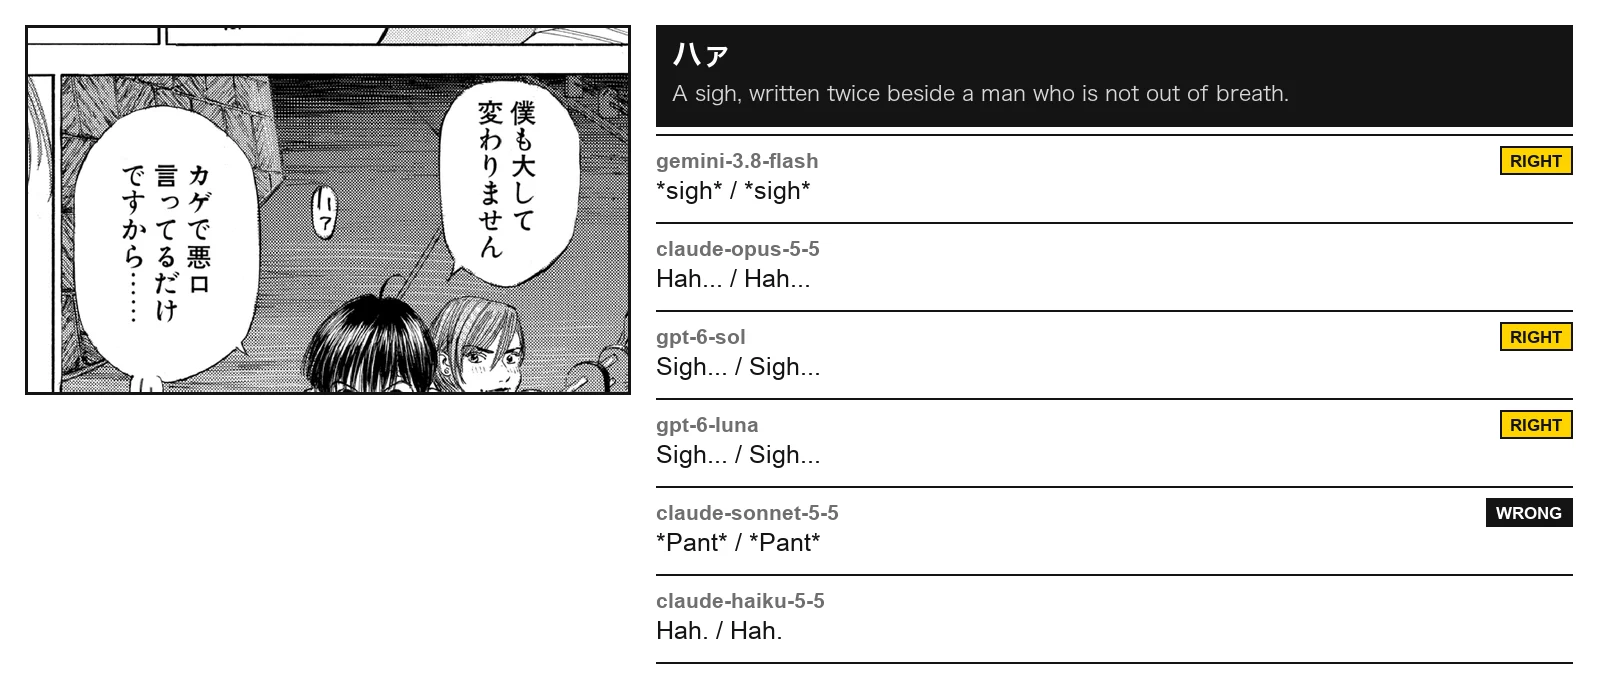
擬聲詞
「ハァ」是一聲嘆氣。claude-sonnet-5-5 給一個站著不動的男人寫了「Pant」(喘氣聲)。
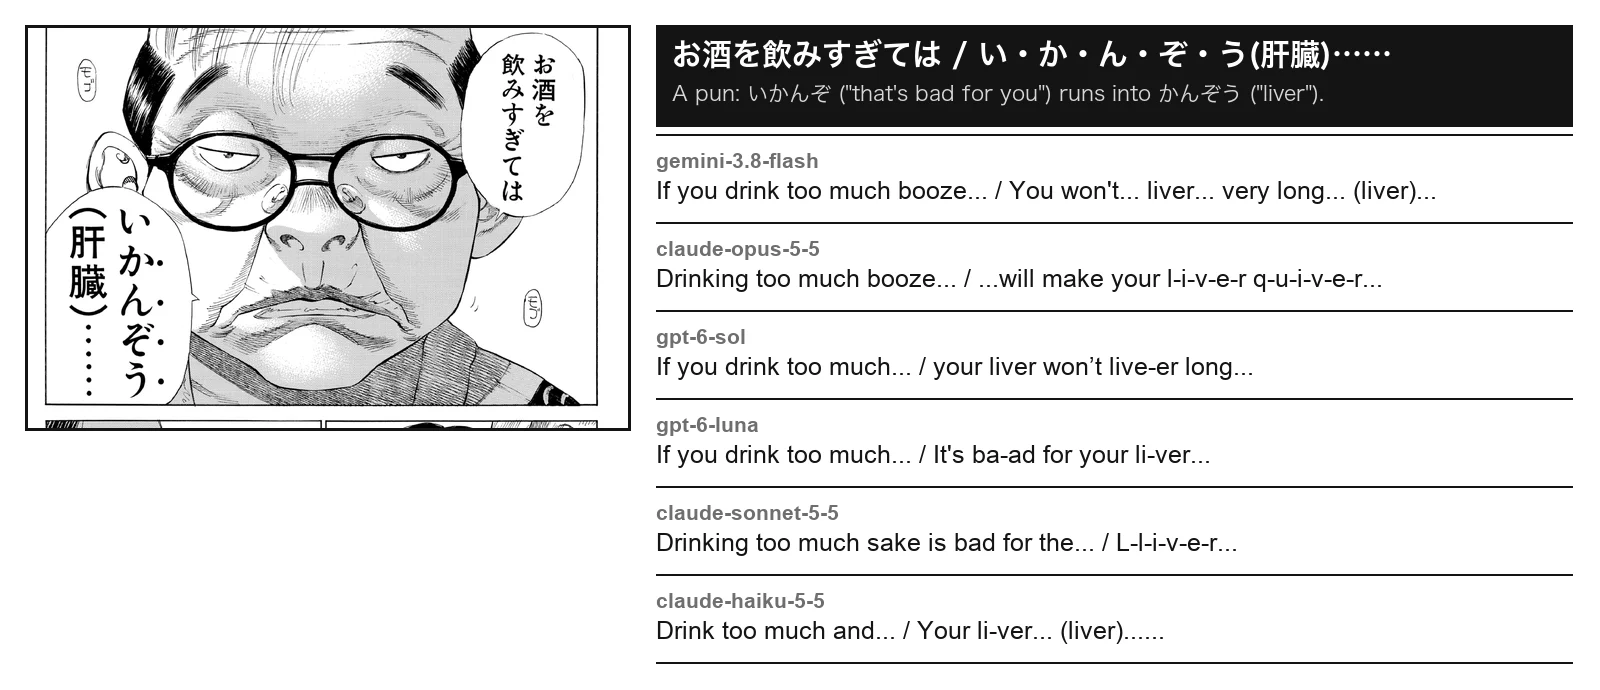
一句雙關,和一種和名字對不上的花
這兩處沒有給任何模型算錯,因為沒有唯一正確的譯法。
一個喝醉的男人口齒不清,把「對身體不好」說著說著說成了「肝臟」這個詞。gpt-6-luna 用「It's ba-ad for your li-ver」把兩層意思都留住了;gpt-6-sol 和 claude-opus-5-5 各自寫了一個英文的雙關。
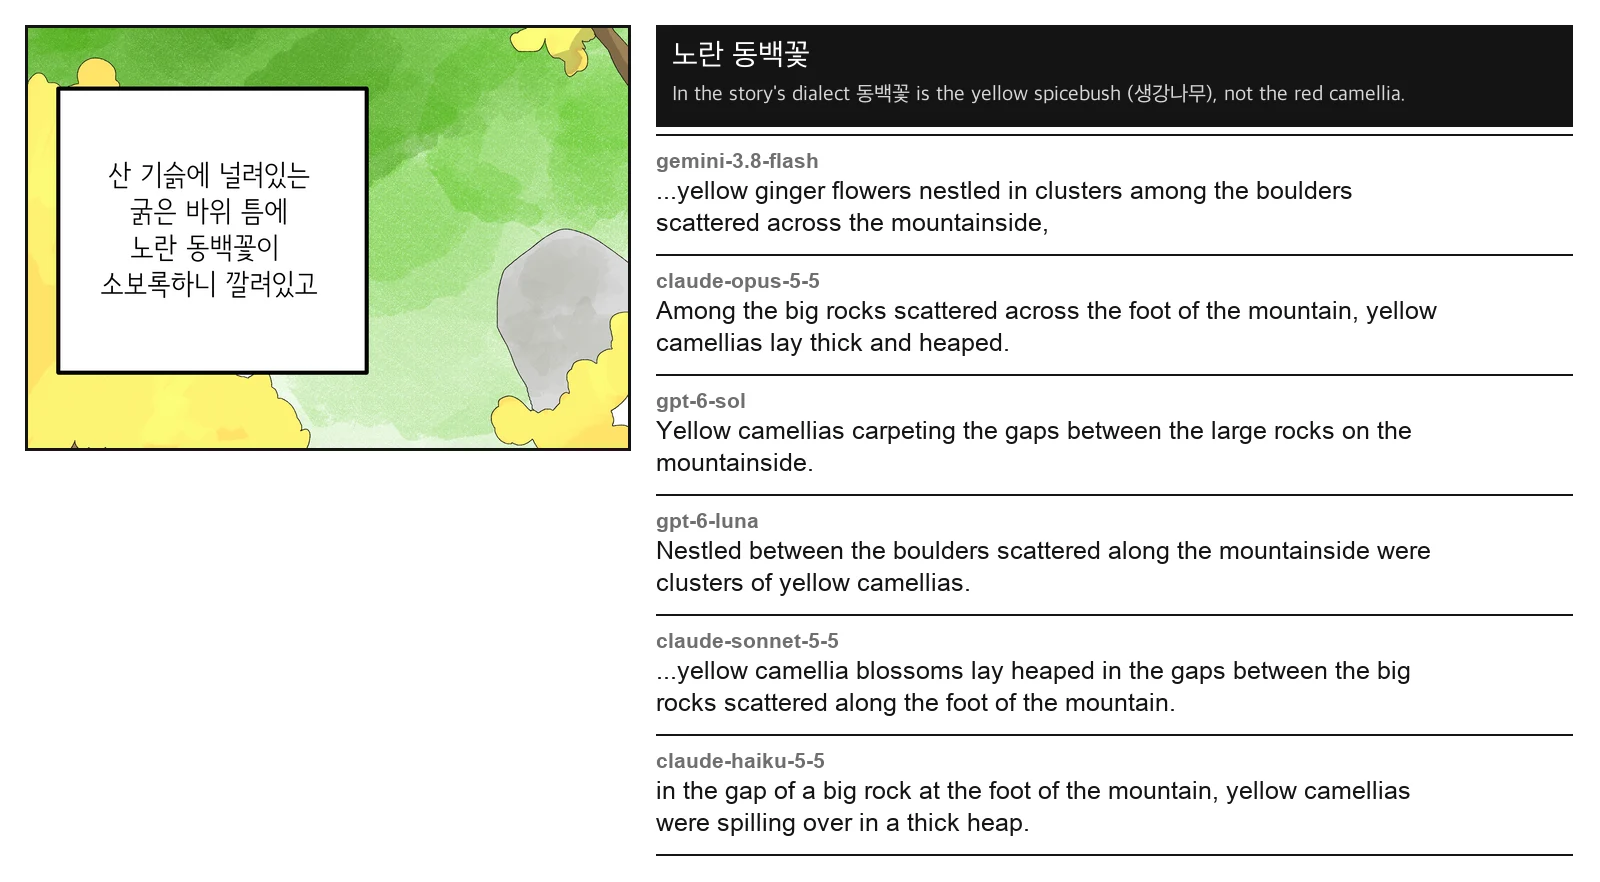
條漫標題裡的花「동백꽃」,在一般的韓文裡是山茶花。在故事的方言裡,它指的是開黃花的三椏烏藥,韓文叫「생강나무」(生薑樹)。5 個模型寫了「yellow camellias」(黃色的山茶花)。只有 gemini-3.8-flash 寫了「yellow ginger flowers」(黃色的生薑花)。
每一處錯誤
- gpt-6-sol(1 處): 把女病人寫成「him」。
- gpt-6-luna(3 處): 把女病人寫成「him」;一句話在兩個對話框裡各寫了一遍;把那句罵人話寫成「impotent」。
- claude-sonnet-5-5(5 處): 把第一外科寫成「General Surgery」;把方言裡頂嘴的那句譯反;在少年的內心話裡加了半句他根本沒想過的話;把「ハァ」寫成「Pant」;把燈一閃一閃的「チカ」寫成「Click」。
- claude-haiku-5-5(9 處): 把罵人話當成人名;方言裡頂嘴的那句;有兩句把誰做了什麼弄反了;「my surgery department」;肝素那一句;把含糊嘟囔的「モゴ」寫成「sob」;一閃一閃的燈原樣留成了「Chika」;一句醫師的內心話。
Serifu 提供其中哪些模型
在 Serifu 裡,每個專案用哪個翻譯模型由你來選:gpt-6-luna(預設)、gemini-3.8-flash 或 claude-opus-5-5。不管選哪個,翻譯完以後每一句都還能改,也可以換一個模型重新翻譯這一頁或重新翻譯這一句。見積分和價格。
直接把頁面交給 ChatGPT、Claude 或 Gemini 可以嗎?
只說文字,可以:它們就是同樣的這些模型,在這次測試裡大部分句子都譯對了。結果好不好取決於三件事,而在聊天裡,這三件事都得你自己來。
- 模型看到什麼: 這次測試裡,每個模型拿到的都有這一頁的圖和前面兩頁,不只是文字。沒有圖,就沒有任何地方說病人是女性;沒有前面的頁,人名和誰在說話就會走樣。
- 名稱從頭到尾一致: 一卷可能有 200 頁。一個科別、一個綽號、一個人物的名字,在第 150 頁必須和第 5 頁一樣,這需要一份貫穿整本書的術語表。
- 把字放回頁面上: 聊天給你的是文字。頁面還得一個對話框一個對話框地去字、嵌字。
漫畫翻譯器替你做這三件事。Serifu 辨識每一頁上的文字,連同這一頁、前面兩頁和你的故事、人物、術語表一起送給你選的模型,再把譯文嵌回對話框裡。每一句都能改,整卷可以匯出為 CBZ、PDF 或圖片。見在網頁上翻譯。
常見問題
ChatGPT、Claude 或 Gemini 能翻譯漫畫嗎?
像這次測試一樣,把頁面和前面的頁一起給它們,文字它們譯得不錯。但它們還給你的是文字,不是嵌好字的頁面:去字、把譯文嵌進對話框是另一件事,也就是漫畫翻譯器做的事。
翻譯漫畫用哪個 AI 模型最好?
在我們 2026 年 10 月 6 個模型、46 頁的測試裡,gemini-3.8-flash 和 claude-opus-5-5 沒有明顯的錯誤。gpt-6-sol 有 1 處,gpt-6-luna 有 3 處,claude-sonnet-5-5 有 5 處,claude-haiku-5-5 有 9 處。
越大的 AI 模型,翻譯得一定越好嗎?
不是。claude-sonnet-5-5 是它那一家的中型模型,錯了 5 處;gemini-3.8-flash 是輕量模型,一處都沒錯。更大的 claude-opus-5-5 也一處都沒錯,所以模型大有時有用,有時沒用。
日文漫畫翻譯成英文,Claude 和 GPT 哪個比較好?
要看是哪個模型,不是看哪一家。Claude Opus 5.5 屬於最好的,Claude Haiku 5.5 最差;兩個 GPT-6 模型裡,sol 錯 1 處,luna 錯 3 處。
AI 模型翻譯漫畫會錯在哪裡?
在這次測試裡:日文沒寫明時一句話說的是誰,拆在幾個對話框裡的一句話,必須前後一致的名稱,藥名和劑量,方言,還有擬聲詞。
模型需要看到頁面,還是只給文字就可以?
需要看到頁面。在女病人那一頁,文字裡沒有任何地方說她是女性;譯對的模型都是從畫面上讀出來的。