漫畫 OCR
漫畫 OCR 是把漫畫頁上的文字讀出來:氣泡裡的對白、旁白裡的敘述、畫進畫面裡的狀聲詞。Serifu 讓視覺模型一次看整頁,把讀到的內容一句一句顯示出來,並在同一次執行裡翻譯。
什麼是漫畫 OCR?
OCR 是光學字元辨識:把圖片裡的文字變成電腦能用的文字。漫畫 OCR 做的是漫畫頁上的這件事,比聽起來難:對白畫在氣泡裡,敘述在旁白裡,狀聲詞是畫面的一部分,日文和中文還是從右往左的直排。一個氣泡讀錯,這一句的譯文也會錯。
Serifu 怎麼讀一頁漫畫
每一頁都走這四步。
先找出每一處文字
你電腦上的偵測器找出氣泡、旁白和狀聲詞;分割把每個氣泡的輪廓描出來,一個區域不會跨過兩個氣泡。不用手動輸入,也不用先畫框。
整頁一起讀
整頁圖、每一處文字的裁圖,連同前面兩頁、你的術語表和你告訴 Serifu 的故事,一起交給視覺模型。有了這些上下文,人名、代名詞和數字才能從上一頁到下一頁保持一致,也才能分清狀聲詞和一句對白。
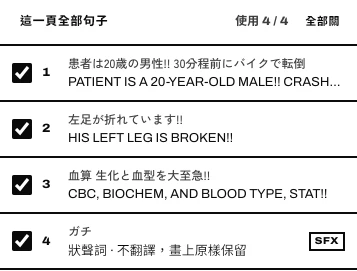
讀到的內容給你看
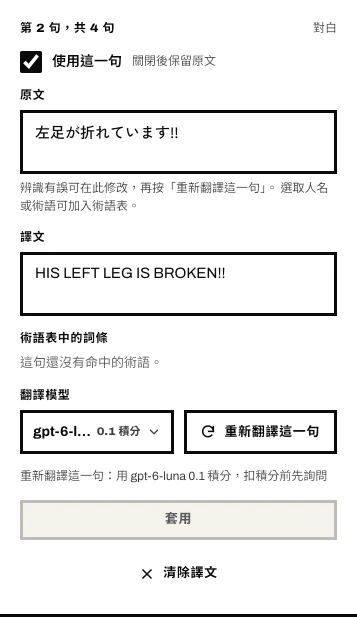
選中一個氣泡,原文就在譯文旁邊,一句一句對著看。哪個字讀錯了,改原文,再「重新翻譯這一句」;名字要統一,就加進術語表。辨識結果不是只能接受的黑箱。
漏掉文字的時候
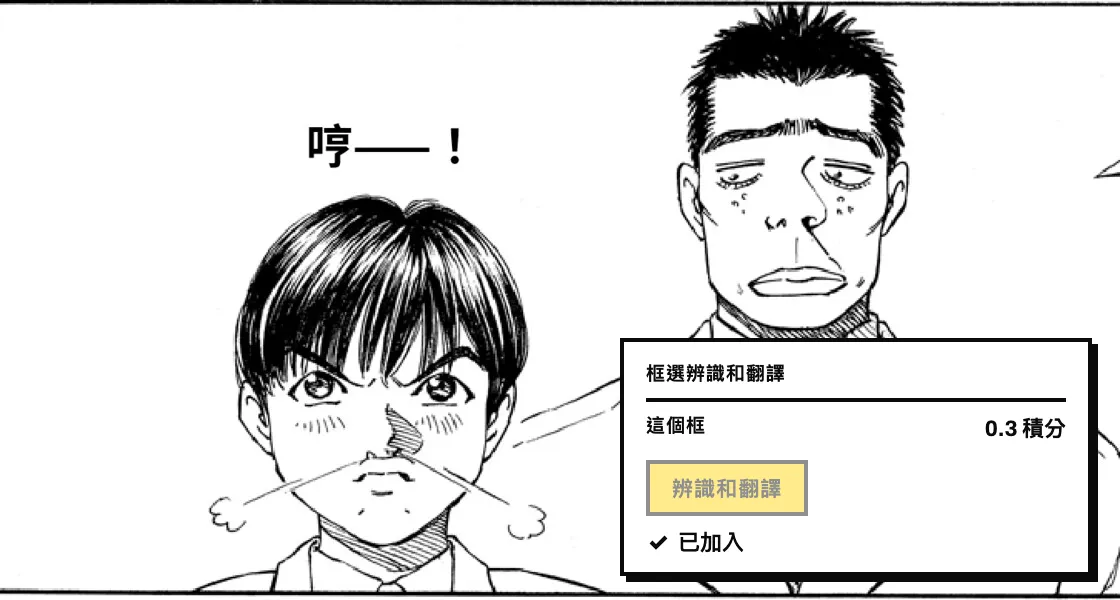
背景裡的招牌、壓在畫面裡的狀聲詞、偵測器沒找到的氣泡:用「框選辨識和翻譯」只讀這一處,就地嵌好。用「遮擋」讓 Serifu 把一塊區域當成空白;整頁讀得不對,就用「重新辨識和翻譯這一頁」從圖上再讀一次。
Serifu 和 manga-ocr 模型比一比
manga-ocr 是搜尋漫畫 OCR 時大多數人最先看到的開源模型。我們用同一部日文漫畫佐藤秀峰《ブラックジャックによろしく》第 1 卷裡的 24 張裁圖,讓它和 Serifu 預設的辨識模型各讀一次,再逐張人工核對。每個字都對才算對。差別最大的是畫在畫面裡的字。這只是一卷漫畫上的小測試,能看出各自會犯什麼錯,不能當作錯誤率。
| 辨識模型 | 全部 24 張 | 氣泡裡(8) | 畫面裡(16) |
|---|---|---|---|
| Serifu 預設辨識模型(gemini-3.8-flash) | 24 / 24 | 8 / 8 | 16 / 16 |
| manga-ocr(開源) | 17 / 24 | 7 / 8 | 10 / 16 |
漫畫 OCR,五種語言
Serifu 讀日文、韓文、簡體中文、繁體中文和英文漫畫。沒有 OCR 模型要選,也沒有東西要裝:一個由我們挑選並測過的辨識器,五種語言都用它,直排也在內。
用 Serifu 讀一頁漫畫
- 01
匯入這一卷
一資料夾的頁、CBZ、ZIP、PDF 或圖片都行;選要處理的頁。Serifu 會排好順序,開始前讓你確認頁序和閱讀方向。
- 02
辨識和翻譯
選翻譯模型,開始。每一頁從圖上辨識,並在同一次執行裡翻譯,價格先顯示:每頁 1 積分起。辨識包含在這個價格裡,不另外收。
- 03
檢查要緊的句子
打開一頁,選中氣泡:原文和譯文都在。哪個字讀錯了,改好再「重新翻譯這一句」;也可以不改,接著讀。Serifu 漏掉的一句,用「框選辨識和翻譯」補上。
漫畫 OCR 的價格
辨識包含在「辨識和翻譯一頁」裡:gpt-6-luna 每頁 1 積分、gemini-3.8-flash 1.5 積分、claude-opus-5-5 3 積分,辨識和第一次翻譯一起算。「框選辨識和翻譯」是辨識 0.2 積分加模型的每句價格,先問再扣。註冊送 5 積分,積分包永不過期。
漫畫 OCR 常見問題
Serifu 可以單獨做 OCR 嗎?
辨識包含在「辨識和翻譯」裡:一頁從圖上辨識並在同一次執行裡翻譯,按模型的每頁價格收。單獨辨識不另收,也不能只辨識不翻譯。
漫畫 OCR 能讀哪些語言?
日文、韓文、簡體中文、繁體中文和英文。
直排日文也能讀嗎?
能。日文和中文的直排按行讀,從右往左,跟畫出來的一樣。
能把文字匯出來嗎?
還不能。原文和譯文在編輯器裡一句一句留著,跟著專案走。匯出成文字檔還不支援。
漏了一個氣泡,或讀錯了一個字怎麼辦?
偵測器漏掉的地方用「框選辨識和翻譯」,讀出來後就地嵌好。讀錯的字改一下就好:改原文,再「重新翻譯這一句」。整頁都讀得不對,就用「重新辨識和翻譯這一頁」。
頁面會上傳到 Serifu 嗎?
偵測器在你電腦上跑。頁面會送去辨識和翻譯,不會留在 serifu.net;這一卷留在你的電腦上。
需要顯示卡嗎?
不需要。辨識在 Serifu 的伺服器上跑:沒有模型要下載,也不用有顯示卡。客戶端有 macOS 和 Windows 版。
可以整卷一起做嗎?
可以:用「辨識和翻譯 N 頁」跑整卷,每一頁開始處理時才扣費。